이미지 생성 AI
생성형 AI를 공부하다 보면 텍스트 생성뿐 아니라 이미지 생성도 자연스럽게 접하게 된다.
이번에는 Google Cloud 학습 영상 내용을 바탕으로, 이미지 생성 모델의 흐름과 그중에서도 많이 사용되는 디퓨전 모델(Diffusion Model) 이 무엇인지 정리해봤다. 원문 강의에서는 이미지 생성의 대표적인 방식들을 간단히 소개한 뒤, 디퓨전 모델의 핵심 원리를 설명한다.
이미지 생성 모델에는 어떤 방식이 있을까
이미지 생성은 최근에 갑자기 등장한 개념은 아니다.
디퓨전 모델 이전에도 여러 방식의 생성 모델이 연구되고 활용되어 왔다.
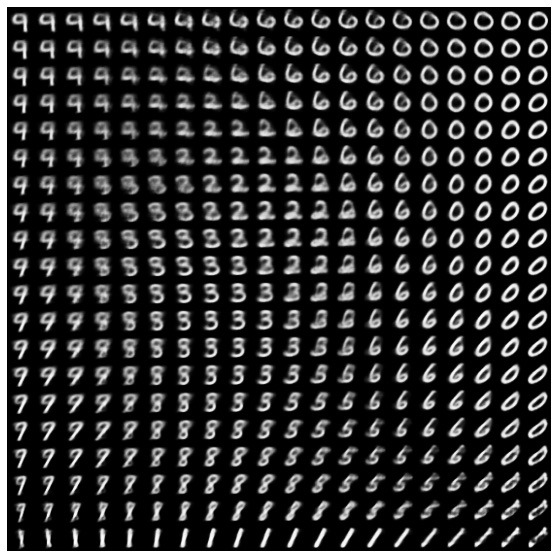
1. VAE(Variational Autoencoder)
VAE는 이미지를 한 번 압축된 표현으로 바꾼 뒤, 다시 원래 이미지로 복원하는 구조를 가진다.
이 과정에서 단순히 이미지를 복원하는 것이 아니라, 데이터가 어떤 분포를 가지는지도 함께 학습한다.
쉽게 말하면 이미지의 특징을 압축해서 이해한 다음, 다시 그럴듯하게 복원하는 방식이라고 볼 수 있다.
2. GAN(Generative Adversarial Network)
GAN은 생성기와 판별기, 두 개의 신경망이 경쟁하는 구조다.
생성기는 가짜 이미지를 만들고, 판별기는 그 이미지가 진짜인지 가짜인지 구분한다.
이 경쟁이 반복되면서 생성기는 점점 더 진짜 같은 이미지를 만들게 된다.
딥페이크 같은 개념도 이런 생성 모델의 맥락에서 자주 언급된다.
3. 자기회귀 모델(Autoregressive Model)
자기회귀 방식은 이미지를 순차적으로 생성한다.
텍스트를 한 토큰씩 생성하는 언어모델처럼, 이미지도 어떤 순서를 따라 조금씩 만들어 가는 방식이다.
최근의 일부 이미지 생성 접근은 이런 언어모델 방식에서 많은 영감을 받았다.

이번 글의 핵심, 디퓨전 모델
이번 강의에서 중심이 되는 것은 디퓨전 모델이다.
디퓨전 모델은 비교적 최근에 크게 주목받은 이미지 생성 방식으로, 특히 2020년 이후 연구와 산업 영역에서 빠르게 확산됐다. 강의에서도 최근 이미지 생성 분야에서 큰 가능성을 보여준 모델 계열로 소개한다.
이 모델의 핵심 아이디어는 생각보다 단순하다.
이미지에 노이즈를 조금씩 추가하고,
그 노이즈를 다시 제거하는 과정을 학습한다.
즉, 이미지를 망가뜨리는 과정과 복원하는 과정을 이용해
결국 새로운 이미지를 만들어내는 방식이다.
디퓨전 모델은 어떻게 동작할까
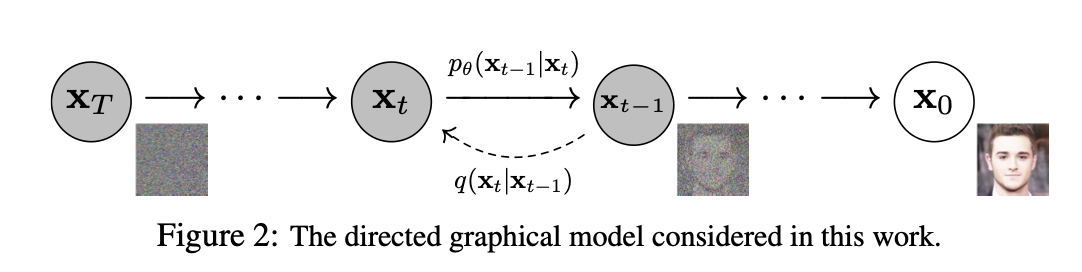
디퓨전 모델은 크게 두 단계로 이해하면 된다.
1. 정방향 확산(Forward Diffusion)
먼저 원본 이미지에 아주 조금씩 노이즈를 추가한다.
처음에는 이미지가 거의 그대로 보이지만, 이 과정을 반복할수록 점점 형태가 흐려지고 결국에는 완전히 랜덤한 노이즈처럼 변한다.
강의에서는 초기 연구에서 이 과정을 약 1000번 반복했다고 설명한다.
충분히 많이 반복하면 원래 이미지의 구조는 완전히 사라지고 순수한 노이즈만 남게 된다.
2. 역방향 확산(Reverse Diffusion)
이제 중요한 것은 반대 방향이다.
노이즈가 섞인 이미지를 보고, 여기서 어떤 노이즈가 들어갔는지를 모델이 예측하도록 학습한다.
학습할 때는 실제로 어떤 노이즈를 넣었는지 알고 있으므로, 모델이 예측한 값과 실제 값을 비교하면서 오차를 줄여 나갈 수 있다.
이 과정을 반복하면 모델은 점점 더 노이즈를 잘 제거하게 된다.
결국에는 심하게 깨진 이미지에서도 원래 구조를 복원하는 방향을 학습하게 되는 것이다.
그럼 이미지는 어떻게 생성되는 걸까
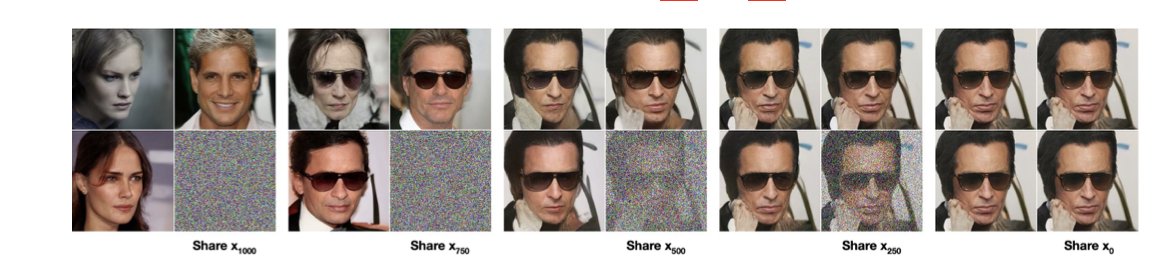
생성 과정은 오히려 더 직관적이다.
처음부터 이미지로 시작하는 것이 아니라,
완전한 랜덤 노이즈에서 시작한다.
그리고 학습된 모델에 이 노이즈를 넣는다.
모델은 현재 이미지에 포함된 노이즈를 예측하고, 우리는 그 노이즈를 조금 제거한다.
이 과정을 여러 번 반복하면 점점 의미 없는 잡음에서 형태가 생기고, 마지막에는 하나의 새로운 이미지가 만들어진다.
즉, 디퓨전 모델은 단순히 사진을 복사하는 것이 아니라,
학습한 이미지 분포를 바탕으로 새로운 이미지를 생성하는 방식이다.
디퓨전 모델이 활용되는 방식
강의에서는 디퓨전 모델의 활용을 크게 두 가지로 설명한다.
비조건부 생성
비조건부 생성은 별도의 입력 없이 이미지만으로 학습하는 방식이다.
예를 들어 얼굴 이미지 데이터셋을 학습하면, 새로운 얼굴 이미지를 생성할 수 있다.
또 저해상도 이미지를 더 선명하게 바꾸는 초해상도(super resolution) 도 대표적인 예시다.
조건부 생성
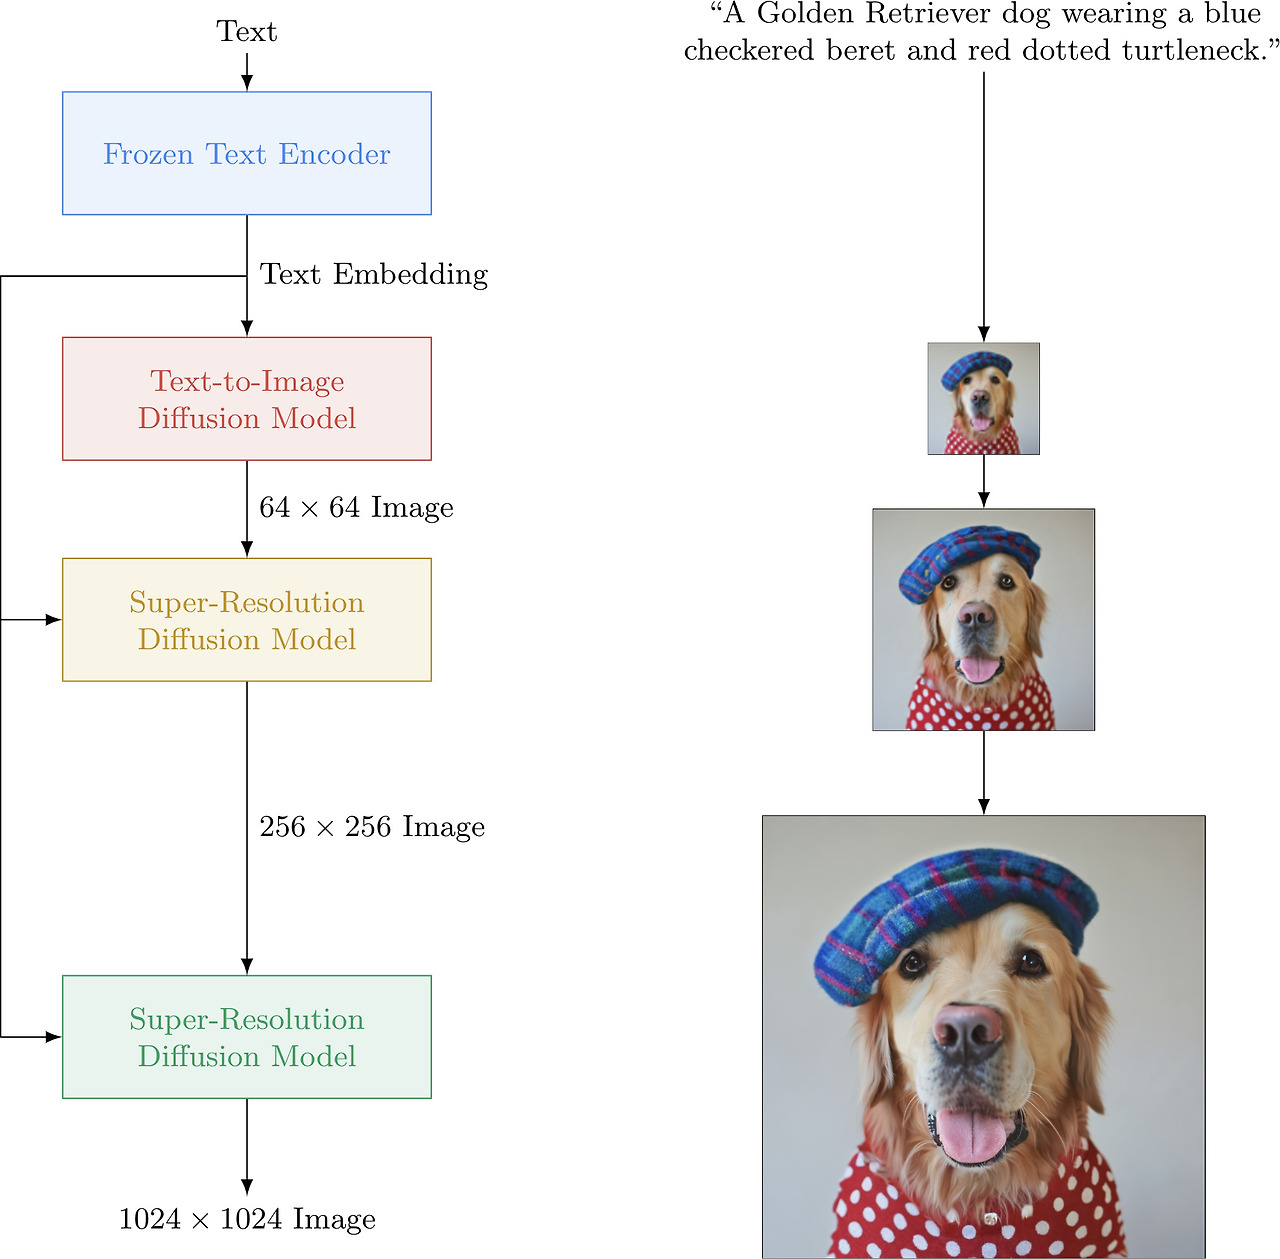
조건부 생성은 텍스트나 다른 이미지를 함께 입력으로 활용하는 방식이다.
대표적으로 우리가 익숙한 텍스트-투-이미지(Text to Image) 가 여기에 해당한다.
문장을 입력하면 그 설명에 맞는 이미지를 생성한다.
이외에도 이미지 일부를 자연스럽게 채워 넣는 인페인팅,
텍스트 지시를 기반으로 이미지를 수정하는 이미지 편집도 가능하다.
LLM과 결합되는 이미지 생성
강의 후반에는 디퓨전 모델과 LLM의 결합도 언급된다.
텍스트를 더 잘 이해하는 언어모델과 디퓨전 기반 이미지 생성 모델을 함께 활용하면,
문맥을 더 잘 반영하고 더 사실적인 이미지를 만들 수 있다는 것이다.
즉, 이미지 생성도 이제 단순히 그림을 만들어내는 수준을 넘어서
텍스트 이해 능력과 결합된 멀티모달 생성으로 발전하고 있다고 볼 수 있다.
정리
디퓨전 모델은
이미지에 노이즈를 조금씩 추가한 뒤,
그 노이즈를 다시 제거하는 과정을 학습해서
새로운 이미지를 만들어내는 생성 모델이다.
처음 접하면 수식 때문에 어렵게 느껴질 수 있지만,
개념 자체는 생각보다 단순하다.
- 이미지를 조금씩 망가뜨린다.
- 그걸 다시 복원하는 방법을 배운다.
- 결국 완전한 노이즈에서도 이미지를 만들어낼 수 있게 된다.
이미지 생성 모델을 처음 공부할 때는
VAE, GAN, 디퓨전 모델을 순서대로 비교해보면 전체 흐름을 이해하는 데 도움이 된다.
그리고 최근에는 여기에 LLM까지 결합되면서 이미지 생성의 활용 범위가 더 넓어지고 있다.
한 줄 요약
디퓨전 모델은 노이즈를 제거하는 법을 학습해서, 노이즈로부터 이미지를 생성하는 모델이다.